 开发咨询热线:

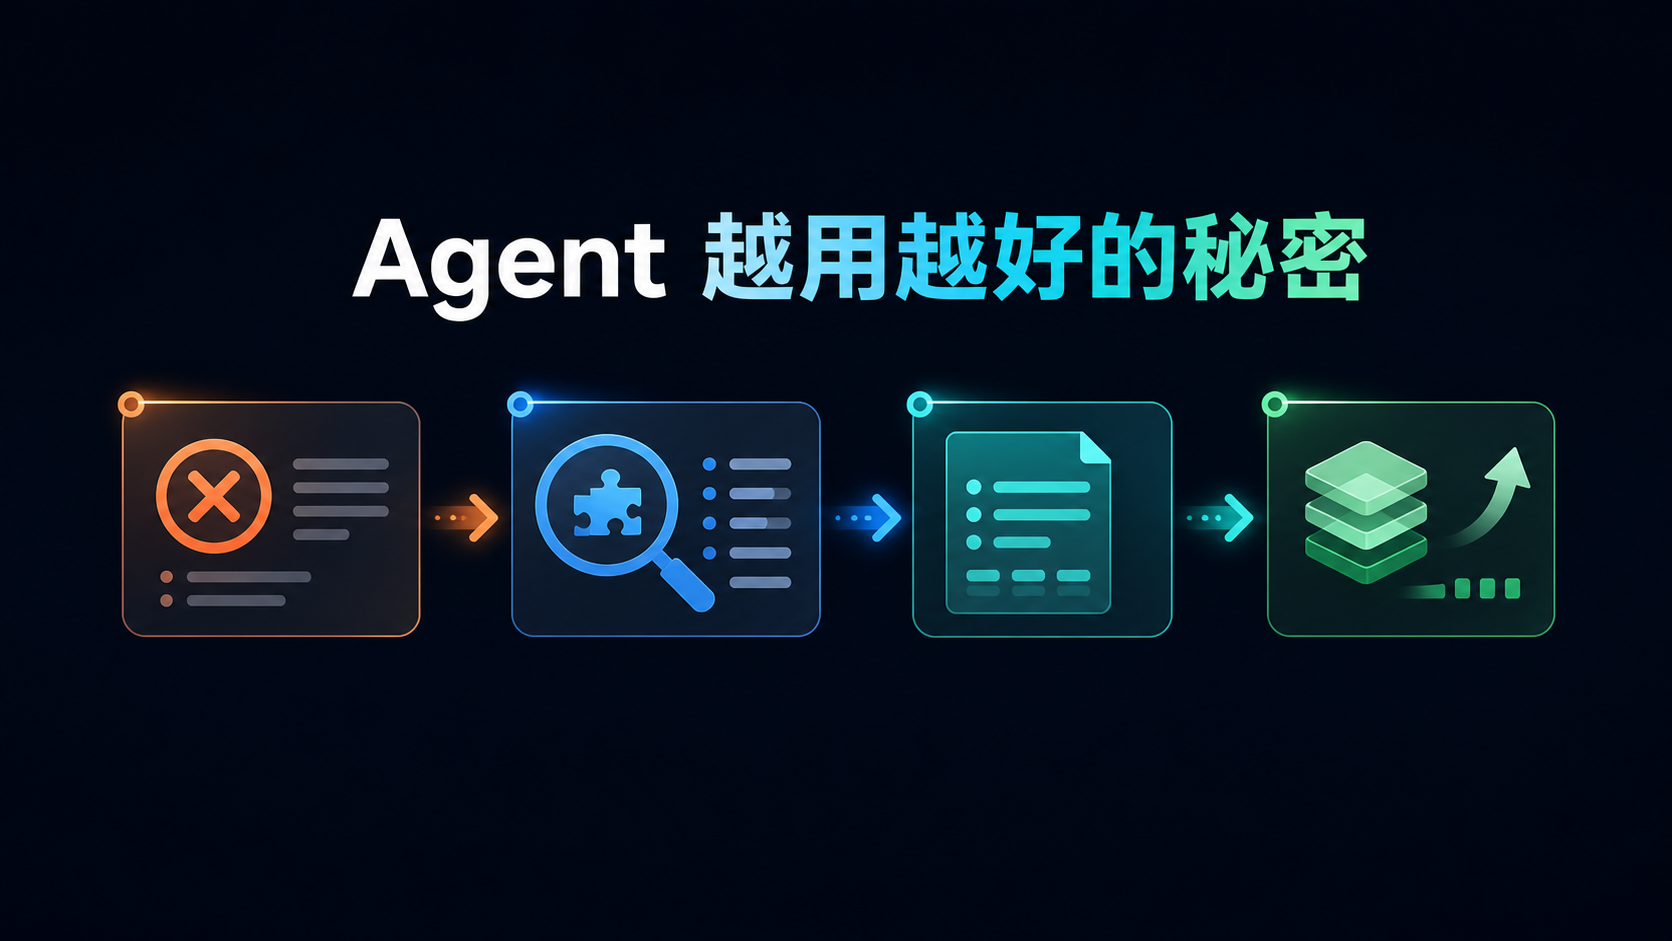
现在很多团队做 Agent,最关心的是任务成功率:能不能查资料、写代码、调用工具,把工作从头做到尾。
但我越来越觉得,真正拉开差距的不是 Agent 第一次能完成多少任务,而是它做不了的时候,系统接下来会发生什么。
普通 Agent 遇到能力之外的需求,只会回复一句“暂不支持”。任务到这里结束,用户失望,团队也不知道刚刚错过了什么。更成熟的做法,是让这次失败自动进入产品改进闭环:Agent 识别自己缺少的工具、权限或上下文,把它整理成一条可评审的需求,再交给人决定是否值得开发。
最值得关注的不是自动提需求,而是自动发现能力缺口
Linear 团队分享过一个很有意思的实践:当 Agent 被要求完成某件事,却发现自己没有合适的工具时,它会报告这个能力缺口,系统再把信息沉淀到 issue 中。
这和“让 AI 随便写一条需求”完全不同。
Linear Agent 本身已经能够理解工作区里的项目、issue、评论和客户请求,也可以创建或更新 issue。把这两种能力连接起来,Agent 就不只是执行已有流程,还能把执行过程中暴露的问题变成结构化反馈。
我认为这才是 Agent 真正有产品价值的一步:失败不再只是一段对话,而是可以被追踪、统计和改进的数据。
我会怎样设计这条反馈闭环
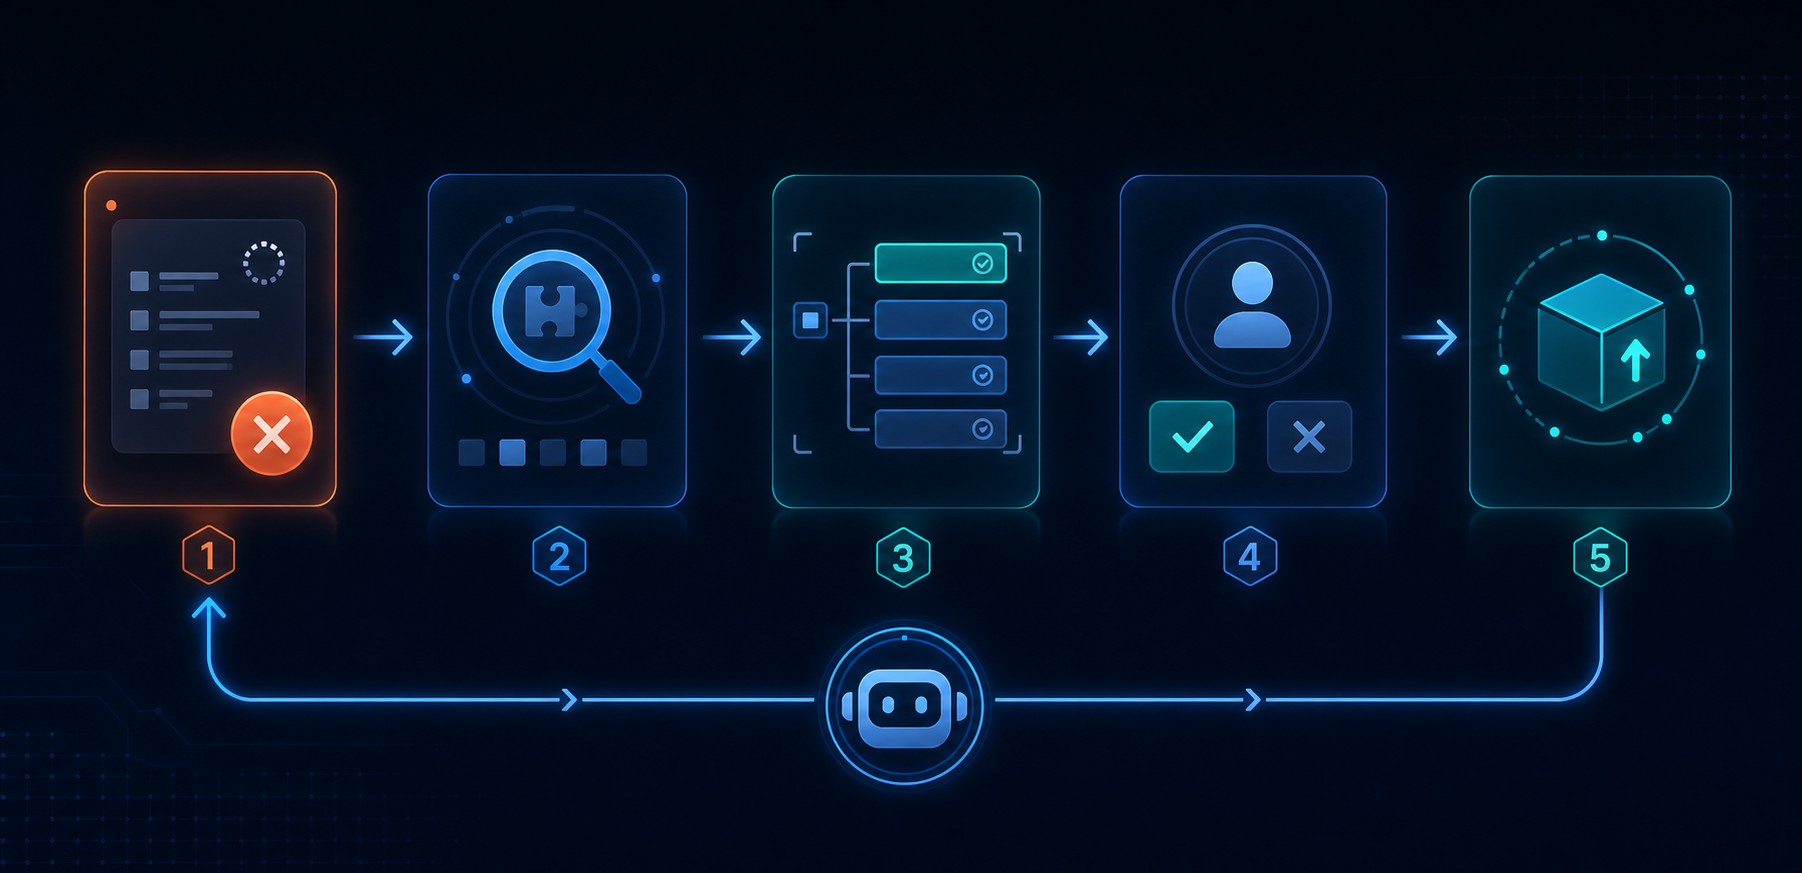
如果让我给团队搭这套机制,我不会让 Agent 一失败就直接往产品列表里塞 issue。那样运行几天,需求池很可能就会被重复问题和偶发错误淹没。
我会把流程拆成五步:
- Agent 先尝试完成任务,并保留调用过程和失败证据。
- 判断失败属于能力缺口、权限不足、上下文缺失,还是普通系统错误。
- 只有确认属于能力缺口,才生成一条结构化候选需求。
- 系统自动查重、聚类,并统计相同需求出现的频率和影响范围。
- 最后由产品或技术负责人确认优先级,而不是让 Agent 自己决定开发什么。
一条合格的候选需求,至少应该说明:用户原本想完成什么、Agent 尝试了哪些动作、缺少什么能力、影响了谁、有没有临时替代方案,以及相关日志在哪里。
这样的人机分工很重要。Agent 负责捕捉现场、整理证据和减少录入成本;人负责判断需求是否真实、是否符合产品方向,以及值不值得投入资源。
最容易踩的坑:把所有失败都当成产品需求
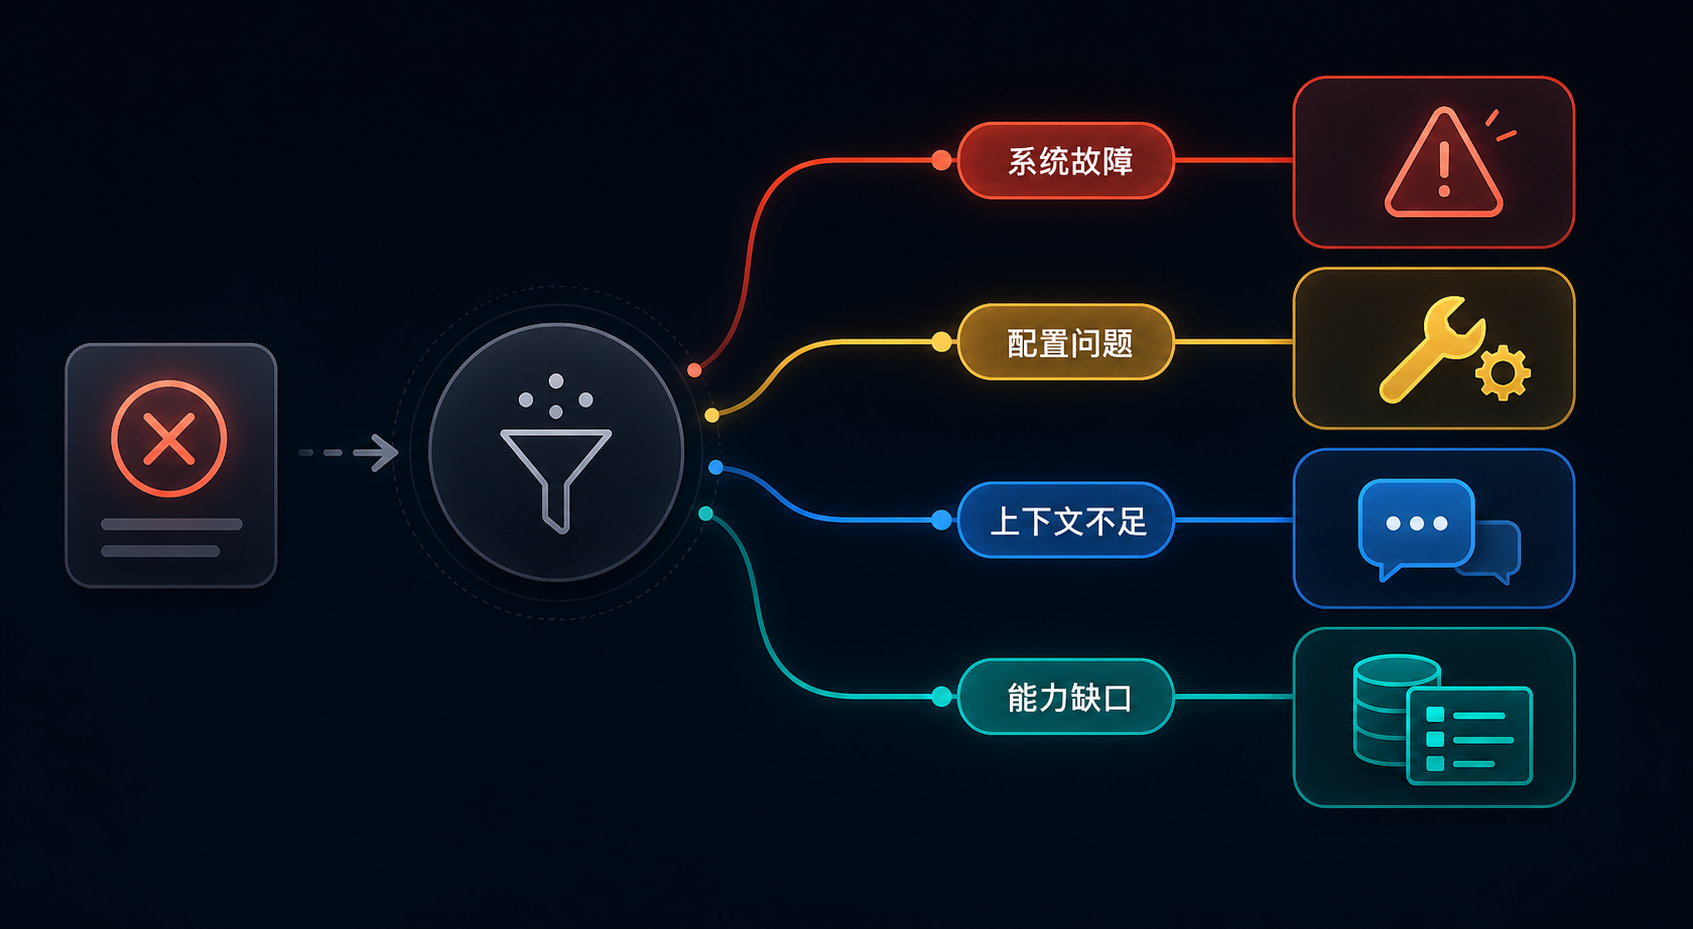
并不是每次失败都意味着应该增加一个工具。
有时只是接口超时,有时是权限配置错误,有时是用户表达含糊,还有时虽然可以实现,但风险和维护成本远高于收益。如果 Agent 无法区分这些情况,所谓“自我改进”最后只会制造大量噪声。
所以这套机制的核心不是自动创建 issue,而是先建立一套稳定的失败分类标准。我通常会至少区分四类:系统故障、配置问题、上下文不足和真实能力缺口。只有最后一类才进入需求池,前三类应该分别流向告警、运维或交互优化流程。
另一个边界是:自动记录不等于自动立项。Agent 可以提出建议,却不应该因为某个用户问了一次,就修改所有人的工作流。Linear 在 Agent 的设计里仍然保留了人的责任:任务可以委派给 Agent,但主要负责人依旧是人。我认同这个原则。
谁现在最适合做这件事
这套方法尤其适合已经把 Agent 放进真实业务流程的团队,例如内部知识助手、客服 Agent、研发助手、内容生产流水线和运营自动化系统。
如果每天只有几次演示调用,先把基本功能跑通更重要。但当一个 Agent 已经面对大量重复任务,团队又经常听到“它为什么不能顺便做这一步”,就应该开始记录能力缺口了。
最低成本的版本甚至不需要复杂架构:给失败记录增加统一字段,定期聚类,再由负责人每周评审一次。等分类准确率和需求量上来后,再逐步接入自动建单、去重和优先级建议。
我的判断
很多人理解的 Agent 自我改进,是让它自己改提示词、写代码,甚至上线新工具。但在真实团队里,这往往太激进,也很难控制风险。
我更推荐先做一个朴素但可靠的版本:让 Agent 知道自己为什么失败,让团队看见这些失败,并让每一次高价值失败都有机会进入下一轮产品改进。
一个只会完成任务的 Agent,是自动化工具。
一个能持续暴露能力边界、帮助团队决定下一步该补什么的 Agent,才开始真正成为产品系统的一部分。